Un asistente de voz local en galego para Home Assistant
Asistente de voz local en galego con Home Assistant: satélite wyoming nunha Orange Pi, palabra de espertar, Whisper na iGPU dun miniPC e voces galegas do Proxecto Nós (phoonnx/celtia) vía Wyoming. Todo en contedores de docker, sen nube.

Hai xa tempo que teño un asistente de voz na casa con Home Assistant. Nesta entrada conto como o teño montado agora: O satélite de voz, a palabra para espertalo (wake word), o recoñecemento de fala (STT) e síntese de voz (TTS) en galego, todo como contedores de docker e sen mandar nada do audio á nube.
En Home Assistant tes que configurar a pipeline de voz:
- O servizo de voz a texto (STT de Speech To Text)
- Un LLM para interpretar o que lle dis (se pode facer sen LLM pero con ordes limitadas)
- O servizo de texto a voz (TTS de Text To Speech)
Todo se interconecta polo protocolo Wyoming de Rhasspy, que Home Assistant entende de xeito nativo: cada servizo de voz é un servidor Wyoming nun contedor, e dende Home Assistant engádense coma integracións. Isto permite repartir o traballo entre dous ordenadores: no meu caso a Orange Pi xestiona Home Assistant, o micrófono e o altavoz, e outro miniPC cunha GPU integrada, executa os modelos de voz.
O satélite de voz e a palabra para espertalo
O satélite o executo na mesma Orange Pi 3B que Home Assistante cun micrófono USB de conferencia (un EMEET OfficeCore M1A).
Vai nun contedor wyoming-satellite que expón o porto 10700; Home Assistant conéctase a el e aparece coma un dispositivo assist_satellite. A palabra para espertar detéctaa outro contedor (tamén na Orange Pi), wyoming-microwakeword: é o modelo “alexa” cunha rede pequena que corre perpetuamente sen consumir case nada. Este é o compose.yml:
  microwakeword:
    image: rhasspy/wyoming-microwakeword:latest
    ports: ["10401:10400"]

  voice-satellite:
    build: ./voice-satellite
    devices: ["/dev/snd:/dev/snd"]
    group_add:
    ports: ["10700:10700"]
    command: >
      --name "voice-satellite"
      --uri "tcp://0.0.0.0:10700"
      --awake-wav "/app/sounds/awake.wav"
      --done-wav "/app/sounds/done.wav"
      --mic-command "arecord -D plughw:2,0 -f S16_LE -r 16000 -c 1"
      --snd-command "aplay -D plughw:2,0 -f S16_LE -r 22050 -c 1"
      --wake-uri "tcp://microwakeword:10400"
      --wake-word-name "alexa"
      --wake-refractory-seconds 10
      --mic-no-mute-during-awake-wav
      --mic-seconds-to-mute-after-awake-wav 0
Por defecto o satélite apaga o micrófono mentres soa o ton de espertar durante medio segundo; se comezas a falar de seguido córtache as primeiras palabras. Os dous últimos flags deixan o micrófono aberto e solucionan o problema (se o eco do ton entra no recoñecemento, se pode cambiar a a 0.2).
O Dockerfile do satélite é sinxelo: clona o repositorio, instala as dependencias e arrinca:
FROM python:3.14-slim

RUN apt-get update && apt-get install -y --no-install-recommends \
    pulseaudio-utils \
    alsa-utils \
    build-essential \
    git \
    && apt-get clean \
    && rm -rf /var/lib/apt/lists/*

WORKDIR /app

RUN git clone https://github.com/rhasspy/wyoming-satellite.git /app

RUN script/setup

#RUN .venv/bin/pip install --no-cache-dir pysilero-vad==2.1.1
RUN .venv/bin/pip install --no-cache-dir webrtc-noise-gain==1.3.0

EXPOSE 10700

ENTRYPOINT ["script/run"]
Recoñecemento e síntese de voz en galego (TTS e STT)
Como era complicado meter todo o código nun post, publiquei este repositorio cos meus contedores:
https://github.com/albertoruibal/wyoming-voice-gl
Ten un script setup.sh que permite escoller o modelo de whisper e a voz a instalar.
Para pasar a voz a texto usa whisper.cpp compilado con -DGGML_VULKAN=1 para correr na iGPU Radeon 780M do meu miniPC. O modelo por defecto é o large-v3-turbo, pero se pode cambiar no setup.sh. Reconócese cada pregunta nuns 1,3 segundos, bastante aceptables.
Para voz a texto usa Phoonnx: un multiplexor de TTS en ONNX feito por TigreGótico para OpenVoiceOS cos modelos do Proxecto Nós e de aHoTTS. Eu uso celtia (proxectonos/celtia), pero se pode escoller no setup.sh. Para expoñelo a Home Assistant cóntase dunha ponte, wyoming-ovos-tts.
O pipeline en Home Assistant
Unha vez arrincados os contedores, en Settings → Devices & services → Wyoming Protocol engádense os tres servizos pola IP do equipo (o satélite xa se descubre só). Despois, en Settings → Voice assistants -> Assist, créase un pipeline “Galician” con:
- Recoñecemento de fala:
whisper-cpp, idiomaGalician - Axente de conversa: Un LLM, eu estou usando ollama cloud cunha subscripción, o meu LLM local é demasiado lento.
- Síntese de voz:
ovos-tts-plugin-phoonnx, idiomaGalician (Spain). A voz se escolle no contedor.
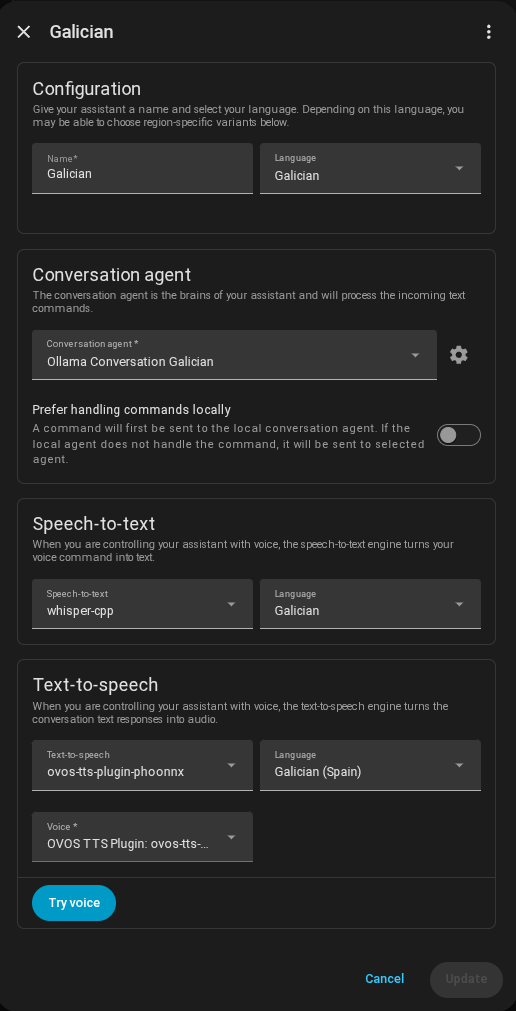
Por último, no dispositivo do satélite selecciónase esa pipeline coma preferida. Contesta preguntas reais nus 2-4 segundos de punta a punta: ~1,3 s de STT, o LLM segundo o modelo e, cando chega a quenda de falar, ~2 s de síntese con celtia (despois do primeiro uso, vai do caché).
Conclusión
Co satélite na Orange Pi, whisper na iGPU do miniPC e as voces galegas do Proxecto Nós teño unha pipeline de voz bastante xeitoxa e todo dentro da rede local (o LLM o utilizo cunha API con zero data retention).
De todas formas os micrófonos de conferencia non son o mellor para detectar wake words, ainda que teña dous micrófonos, o seu DSP está optimizado para filtrar só a fala de cerca e non detecta ben dende lonxe. Teño pendente mercar un Kit Respeaker Lite en Aliexpress para ter o satélite de voz nun dispositivo separado.
(Os enlaces a Aliexpress son de afiliado, danme unha pequena comisón se mercas).